Quando falta conteúdo Web, teste um artigo exato a partir do URL público através do percurso de recolha configurado. O problema é normalmente de acessibilidade, configuração da fonte, canonicalização, metadados, filtragem ou tempo de atualização, e não simplesmente de saber se a página funciona no seu próprio navegador.
1. Teste o URL público final do artigo#
Abra o URL canónico exato do artigo numa janela privada do navegador. Tem de devolver 200 sem início de sessão, barreira de consentimento, restrição geográfica, 401, 403, 404 ou desafio anti-bot. Siga os redirecionamentos e teste o URL final, não apenas a página inicial. Uma firewall de aplicações Web (WAF) pode permitir o acesso ao seu navegador e bloquear um crawler.
Se o seu site restringir os crawlers, utilize a lista de autorizações atual e os endpoints de verificação descritos em Configurar a Nonli no seu site. Os endpoints legíveis por máquina /crawler-ips.json e /crawler-ips.txt anunciam atualmente apenas endereços de saída IPv4; a Nonli não publica atualmente nenhum endereço IPv6 de crawler para incluir na lista de autorizações. Esse guia e esses endpoints são a fonte de referência para o snippet do SDK e para os endereços dos crawlers; não copie um endereço antigo de uma mensagem do suporte.
2. Identifique o percurso de recolha#
Os diferentes percursos têm pré-requisitos diferentes:
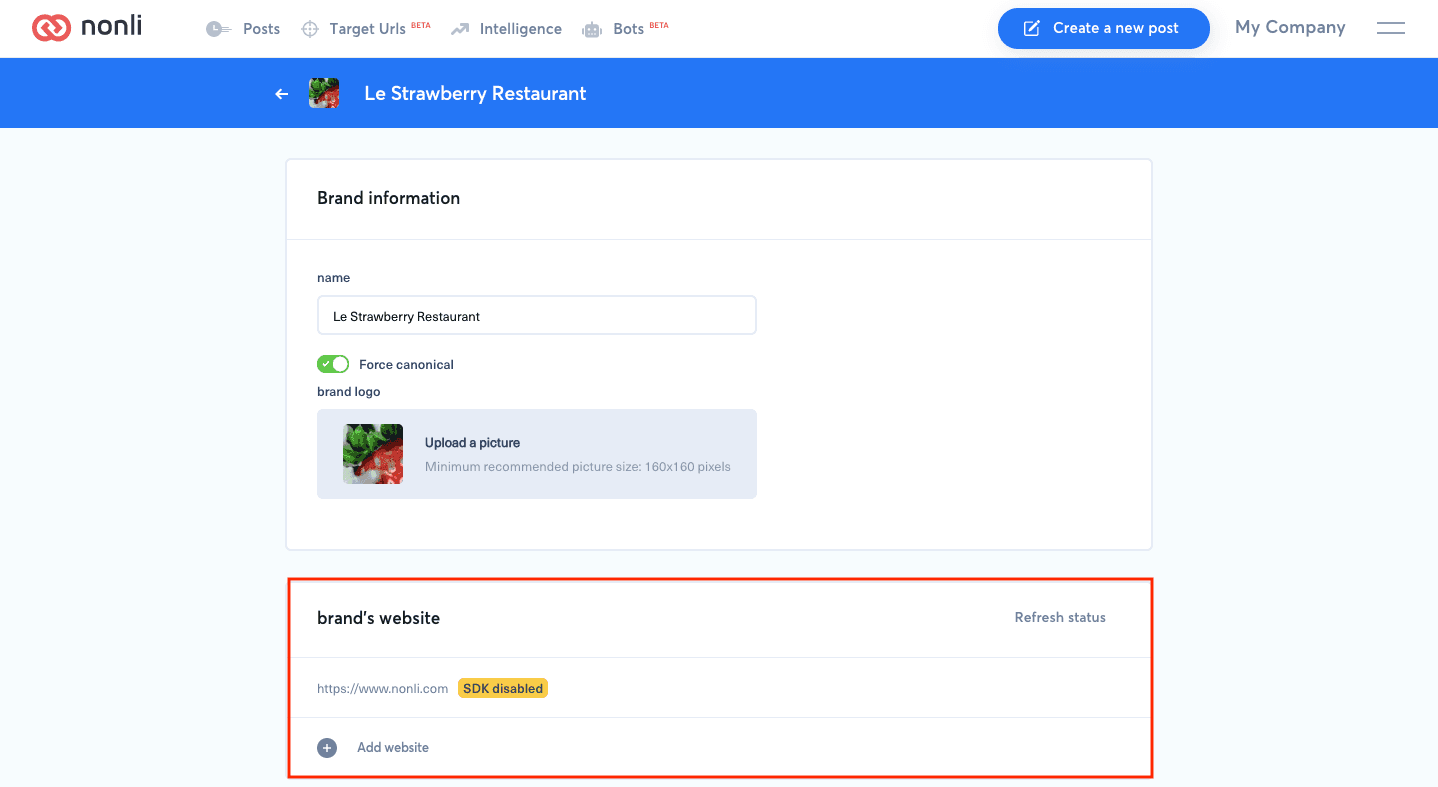
- SDK da Nonli: o script tem de ser carregado em todos os modelos de artigo elegíveis e estar ativado para a marca. Num gestor de tags, confirme que as regras de consentimento, as exclusões de URL, os ambientes apenas de pré-visualização ou as condições de acionamento não ignoram as páginas de artigos.
- RSS: o item tem de estar presente no feed configurado com um URL e uma data de publicação estáveis. Consulte o guia de configuração do RSS.
- Atualização direta do URL: o URL final tem de estar acessível e os seus metadados disponíveis no momento da atualização.
- Página que não é um artigo: uma página cujo conteúdo muda no mesmo URL, por exemplo a página que mostra a primeira página do jornal, deve ser indicada em URLs to monitor (URLs a monitorizar), no formulário da marca, para que a Nonli a volte a ler aproximadamente a cada três horas.
- Social Listening: são a fonte social e os filtros de contas, e não o SDK do seu site, que determinam o conjunto de resultados.
3. Verifique o domínio, o URL canónico e os metadados#
Confirme que o site está atribuído à marca correta e que o seu domínio aparece no filtro Source (Fonte). Na página do artigo, inspecione o URL canónico final e os metadados visíveis. Um URL canónico que aponta para outra página pode fundir o conteúdo sob um URL diferente.
Forneça um título, uma descrição e uma imagem específicos através de marcação Open Graph ou schema.org. Verifique og:title, og:description, og:image, o link canónico e article:section ou articleSection em JSON-LD quando as categorias forem importantes. URLs de imagem relativos, protegidos, expirados ou extremamente pequenos podem não ser utilizáveis. A precedência completa dos metadados e os exemplos continuam disponíveis no guia de configuração do site.
4. Verifique os filtros do tema e o tempo de atualização#
Encontre o artigo na fonte ou nos dados globais antes de diagnosticar um bot. Depois, verifique os filtros de fonte, domínio, idioma, data, URL, termos de inclusão/exclusão, etiqueta e categoria do tema. Um artigo pode ser recolhido corretamente, mas ficar oculto por um destes filtros. Aguarde que o intervalo de recolha ou de consulta do bot configurado seja executado antes de atualizar repetidamente.
Se o artigo estiver visível no tema, mas não aparecer nenhuma publicação automática, continue com Porque é que o meu bot não publicou este artigo?.
5. O que enviar ao suporte#
Envie o URL final exato do artigo, a hora UTC do teste, o tipo de fonte (SDK, RSS, URL direto ou listening), o estado HTTP e a cadeia de redirecionamentos, os valores do URL canónico e dos metadados apresentados, a marca e o tema afetados e a primeira etapa em que o artigo desaparece. Remova as credenciais privadas dos feeds e nunca envie cookies de sessão, chaves de API ou tokens de acesso.